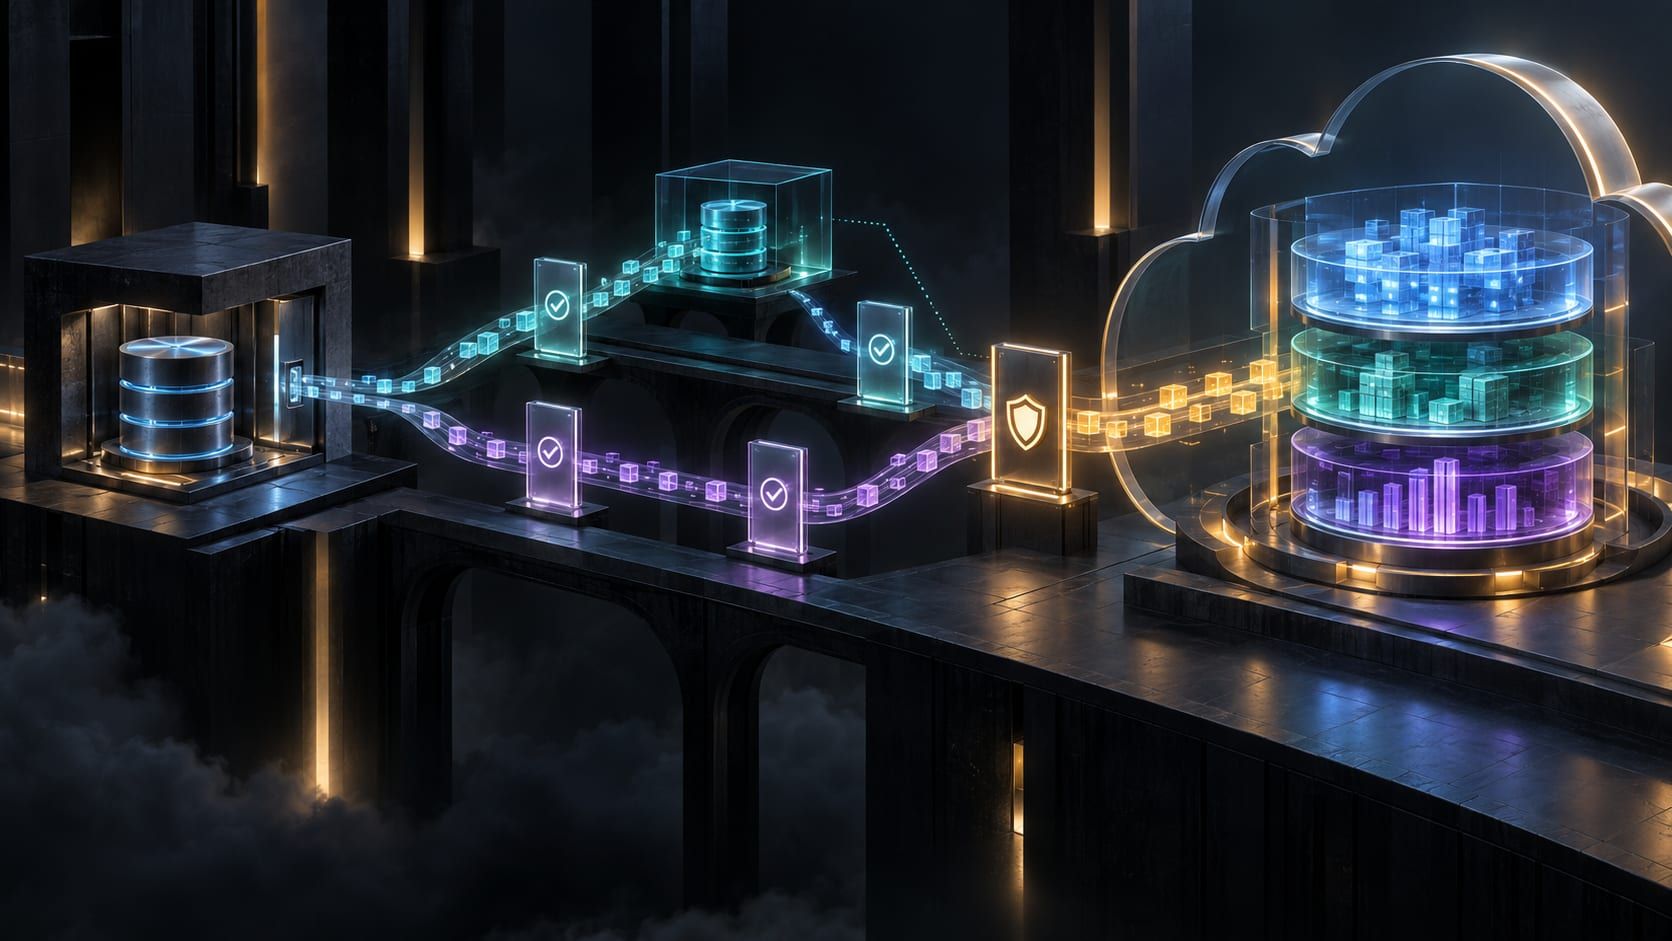
De Docker a Neon: un cutover PostgreSQL con branches, writers y autoridad verificable
Migrar una base de datos no consiste sólo en mover datos. Consiste en trasladar autoridad sin perder identidad, seguridad ni capacidad de volver atrás.
Ése fue el aprendizaje central al mover la autoridad PostgreSQL canónica de jesuserro.com desde un Docker local hasta Neon production. La dificultad no estaba en copiar unas tablas. Estaba en poder responder, antes y después del cambio, cuatro preguntas distintas:
- ¿qué código estamos ejecutando?;
- ¿qué estructura espera ese código?;
- ¿sobre qué timeline de PostgreSQL estamos trabajando?;
- ¿contiene el destino exactamente el mismo corpus?
La respuesta corta tampoco es «migramos un servidor PostgreSQL». Migramos un dominio de datos de una autoridad PostgreSQL a otra.
Esa distinción cambia la forma de diseñar el cutover. Obliga a separar copia y activación, a tratar los writers como capacidades y a probar la receta en un entorno aislado antes de ejecutarla sobre producción.
El punto de partida: una separación segura que empezó a costar
Durante la fase shadow, la separación física era deliberada:
LOCAL DOCKER POSTGRESQL
├── literary.*              canonical
└── taxonomy.*              canonical

NEON PRODUCTION
├── goodreads.*             evidence
├── external_evidence.*     evidence
├── reporting.*             read models
└── control_plane_private.* private runtime state
Reviews y Readings tenían su autoridad canónica en literary.* y taxonomy.*, persistida en un volumen Docker local. Neon alojaba evidencia externa, modelos de lectura y estado privado del control plane.
La frontera física protegía una idea importante: evidencia y estado canónico no son lo mismo. Mientras el nuevo modelo se estaba construyendo, dos PostgreSQL distintos reducían el riesgo de que una herramienta operacional escribiese por accidente en el dominio editorial.
Pero una frontera útil en una fase puede convertirse después en fricción:
- la autoridad durable dependía de un entorno local;
- había dos PostgreSQL físicos que operar y observar;
- las lecturas entre dominios requerían composición en aplicación, FDW o
dblink; - humanos y agentes no podían consultar directamente toda la plataforma de datos;
- ensayar una topología parecida a producción era más incómodo;
- la observabilidad y el análisis cross-domain quedaban fragmentados.
La arquitectura había cumplido su función. El siguiente paso no era eliminar sus límites, sino trasladarlos desde la separación física hacia contratos explícitos de schemas, roles y writers.
Por qué no bastaba con mover el container
El container era el runtime de PostgreSQL, no la identidad de los datos. El corpus persistía en el volumen y en el data directory gestionado por PostgreSQL.
Neon, además, no recibe un data directory local para convertirlo en su almacenamiento. Es PostgreSQL gestionado y controla su almacenamiento físico. Y la base de producción ya contenía otros dominios que debían conservarse.
No queríamos reemplazar Neon ni restaurar por encima de todo neondb. Queríamos incorporar literary.* y taxonomy.* sin alterar goodreads.*, external_evidence.*, reporting.* ni control_plane_private.*.
pg_dump y pg_restore habrían podido transportar schemas o filas. Eso no habría resuelto por sí solo:
- quién tenía autoridad después de la copia;
- qué principal podía escribir en cada dominio;
- si la aplicación estaba usando realmente el destino;
- si el corpus era idéntico;
- si los datos operacionales seguían intactos;
- ni cómo recuperar el servicio si el runtime fallaba tras el cambio.
Mover bytes es una parte de la migración. No es el cutover completo.
Un almacenamiento compartido no implica una autoridad compartida
El resultado físico es más simple:
NEON / neondb
├── goodreads.*               evidence
├── external_evidence.*       evidence
├── literary.*                canonical
├── taxonomy.*                canonical
├── reporting.*               read models
└── control_plane_private.*   private runtime state
Una única base gestionada permite SQL cross-domain, observabilidad común y un destino remoto durable. Sin embargo, la unidad física no convierte todos sus datos en un único dominio.
La regla que lo hace seguro es doble:
shared storage != shared authority
shared storage != shared writer
Los schemas permanecen separados. También los migradores: las migraciones operacionales y Liquibase conservan sus propios ledgers y responsabilidades. Sobre todo, permanecen separados los principals con capacidad de escritura.
Un writer es una capability
Llamar canonical_writer a un rol no le concede propiedades especiales. La seguridad procede de sus atributos, memberships y grants efectivos.
El modelo conceptual era éste:
canonical_writer
├── puede mutar literary.*
├── puede mutar taxonomy.*
└── no puede mutar evidence, reporting ni private

control_plane
└── lectura controlada mediante reporting.*
    no escritura canonical

Liquibase / admin
└── evolución de schema y provisioning
    no runtime normal
El writer canónico es, por tanto, una capacidad acotada. No es simplemente «el usuario de la base de datos». Una connection string que autentica correctamente todavía puede representar el principal equivocado.
Esta separación permite compartir almacenamiento sin colapsar ownership. El control plane no adquiere escritura canónica por estar en la misma base. El writer canónico tampoco puede alterar evidencia ni productos de reporting. El migrador puede evolucionar estructura, pero no es la identidad habitual del runtime.
Neon Branches: parecidas a Git, con un límite importante
La analogía «Neon Branches se parece a Git para PostgreSQL» resulta útil si se usa con cuidado.
Una branch puede nacer del estado de su padre con schema, tablas, índices, constraints y datos. A partir de ahí diverge mediante copy-on-write sin mutar la branch de producción.
production
├── rehearsal fallido
└── rehearsal limpio
    ├── migrations
    ├── roles
    ├── corpus
    ├── fingerprints
    └── security verification
Eso la convierte en un laboratorio production-like: permite encontrar incompatibilidades de PostgreSQL gestionado, probar idempotencia, verificar privilegios y copiar el corpus contra un target realista.
Pero una Neon branch no es un commit Git. No existe una correspondencia uno a uno entre ambos, ni un hash de branch de Neon equivale al SHA del código. Versionan cosas distintas.
Tampoco promovimos la branch de rehearsal para convertirla en production. La usamos para demostrar que la receta funcionaba; después repetimos esa receta, de forma supervisada, sobre production.
Esa elección evita confundir dos objetivos: ensayar un procedimiento y decidir cuál es el timeline autoritativo.
Las cuatro identidades de un entorno verificable
Decir «estamos en la versión correcta» es demasiado ambiguo para una migración. Un entorno relevante se describe mejor como una composición:
Environment =
  Git SHA
  + schema identity
  + Neon branch
  + data fingerprint / point-in-time cuando importe
1. Git identity
El commit SHA identifica el código, los scripts y la intención que estamos ejecutando. Permite ligar una orden, una validación y una evidencia al mismo HEAD exacto.
2. Schema identity
Los changesets aplicados por Liquibase identifican la evolución estructural que la aplicación espera. Dos bases pueden contener filas parecidas y no compartir el mismo contrato de schema.
3. Neon branch identity
La branch identifica el timeline y el entorno PostgreSQL: rehearsal, production u otra derivación. Es la respuesta a «¿sobre qué estado aislado estamos operando?», no a «¿qué commit de aplicación se ejecuta?».
4. Data identity
Un fingerprint determinista identifica el corpus. Permite demostrar que source y target contienen los mismos datos relevantes sin publicar bodies, credenciales ni volcados completos.
Git versiona intención y código. Liquibase versiona evolución del schema. Neon Branches aíslan estados de PostgreSQL. Los fingerprints identifican el corpus cuando necesitamos demostrar igualdad. Ninguna de estas identidades sustituye a las otras.
Copiar datos no cambia la autoridad
Durante el cutover existió una situación intermedia perfectamente válida:
Docker
  corpus canonical
  AUTHORITY = YES

Neon
  copia idéntica
  AUTHORITY = NO
El target podía tener el mismo fingerprint y seguir sin ser la autoridad durable. Todavía no era el destino efectivo de las herramientas canónicas ni del writer previsto.
Por eso el patrón correcto separa tres acciones:
copy
→ verify
→ switch authority
Mezclar copia y activación reduce la ventana de observación y complica la recuperación. Mantenerlas separadas permite verificar el target mientras el source continúa siendo la verdad reconocida. El cutover conceptual ocurre sólo cuando el destino verificado adquiere explícitamente la autoridad.
Dieciséis pasos, cinco fases
El procedimiento real tuvo pasos A–P, pero esas letras eran el protocolo concreto de este proyecto, no un estándar universal. El modelo reutilizable cabe en cinco fases:
| Fase | Pasos | Qué demuestra |
|---|---|---|
| Preservar y medir | A–B | Hay backup recuperable, fingerprint del source y baseline de production. |
| Preparar el destino | C–F | El schema converge, la repetición es idempotente y los privilegios respetan los límites. |
| Planificar y copiar | G–J | El humano aprueba la operación exacta, APPLY copia sólo lo previsto y target = source. |
| Probar invariantes | K–M | La proyección sigue CURRENT, la seguridad se conserva y los datos operacionales no cambian. |
| Cambiar autoridad y preservar recovery | N–P | El runtime usa la nueva autoridad, existe backup posterior y el fallback continúa disponible. |
La agrupación importa porque evita convertir el método en una checklist sin significado. Cada fase responde a una clase de riesgo distinta: pérdida, incompatibilidad estructural, operación no autorizada, regresión y recuperación.
Dos hashes, dos preguntas
El proceso usó hashes truncados en la evidencia pública, pero no eran intercambiables.
El corpus fingerprint respondía:
¿Son éstos exactamente los mismos datos?
source → 9bb2…
target → 9bb2…
El PLAN SHA respondía:
¿Estamos ejecutando exactamente la operación que el humano auditó?
PLAN
  ↓
SHA e454…
  ↓
human approval of e454…
  ↓
APPLY requiring e454…
El fingerprint identifica estado. El PLAN SHA liga intención, revisión y ejecución. Que el target termine con el fingerprint esperado no autoriza cualquier camino para llegar a él; que el plan sea el aprobado tampoco demuestra por sí solo que los datos finales coincidan.
El gate humano debe aprobar el plan exacto
Una autorización genérica como «haz la migración» no equivale a «he revisado esta operación y autorizo este PLAN SHA».
Entre PLAN y APPLY pueden cambiar el source, el target o el código. Por eso APPLY volvió a calcular el plan y exigió el hash aprobado. Si algo hubiese cambiado, debía fallar cerrado como plan obsoleto o incompatible.
El gate humano no era una ceremonia. Acotaba la capacidad de mutación a un artefacto concreto:
human intent
  + exact PLAN
  + expected SHA
  + unchanged inputs
= authorized APPLY
Cuando validate escribió: parar sin empeorar la sorpresa
Otro aprendizaje apareció antes de aplicar los changesets. Esperábamos que Liquibase validate fuese completamente read-only. En aquel target vacío, la ejecución creó las tablas de tracking de Liquibase, aunque no aplicó ningún changeset ni mutó datos canónicos.
La respuesta correcta fue:
unexpected write
→ STOP
→ observar
→ comprobar ausencia de canonical mutations
→ aceptar explícitamente la desviación
→ continuar con nuevo baseline
Una sorpresa no implica automáticamente rollback. Implica STOP, observación y una nueva decisión.
También dejó una regla operacional sencilla: no hagas una segunda escritura sólo para ocultar la primera. Borrar inmediatamente las tablas vacías habría añadido otra mutación y otro riesgo justo antes de que Liquibase fuese a necesitarlas. Tras la auditoría, el estado observado se aceptó como nuevo baseline para el siguiente paso.
Aquí conviene hablar de fallback o recovery cuando eso es lo que realmente existe. Deshacer una migración operacional completa rara vez es equivalente al rollback transaccional de una única operación SQL.
La PR como bus durable entre Director e Implementer
La migración no fue una sesión continua de comandos. La PR actuó como bus durable y audit trail entre tres roles distintos:
Director Order
↓
STEP X ONLY
allowed / forbidden
expected evidence
STOP
↓
Implementer
ejecuta
↓
PR Evidence
CUTOVER STEP X: COMPLETE | BLOCKED
next_step_requested
STOP
↓
Director
audita independientemente
autoriza el siguiente paso
El Implementer mutaba o ejecutaba. El Director observaba, auditaba y decidía. El humano aceptaba riesgo en los gates que lo requerían.
Cada evidencia quedaba ligada al HEAD exacto. Auditar el commit A no autorizaba el commit B. El mismo principio se aplicó al PLAN: aprobar una intención general no autorizaba un payload distinto.
La PR resultó mejor que un chat efímero porque conservó órdenes, límites, resultados, bloqueos y decisiones junto al cambio que los hacía relevantes. El chat podía coordinar; la PR podía sostener una auditoría posterior.
Para qué mereció la pena
El beneficio no es simplemente «tener PostgreSQL en la nube».
La autoridad y el corpus canónico son ahora durables y remotos en Neon; el compute gestionado puede autosuspenderse según configuración. El portátil, WSL y el volumen Docker dejan de ser dependencia de la autoridad de producción, aunque Docker siga siendo valioso para desarrollo, tests desechables y fallback.
La unificación permite además:
- SQL entre evidence, canonical y reporting sin FDW ni
dblink; - observabilidad común sobre métricas, cardinalidades, locks, estructura y queries;
- análisis directo por humanos y agentes con credenciales autorizadas;
- futuros cambios estructurales estudiados sobre branches y evolucionados, tras aprobación, con Liquibase;
- laboratorios production-like de bajo riesgo mediante Neon Branches;
- writers least-privilege aunque la base física sea compartida;
- fingerprints y recovery verificables;
- una base mejor para Data Quality y reporting cross-domain;
- una topología de producción conceptualmente más simple.
La posibilidad de conectar un agente no elimina la frontera de seguridad. ChatGPT u otros agentes pueden consultar la base gestionada cuando el conector y las credenciales autorizadas lo permiten. Lo importante es que esa observación puede abarcar la plataforma de datos sin convertir al agente ni al control plane en writer canónico.
El patrón portable
El esqueleto que conservaría para otra migración es éste:
DISCOVER
↓
freeze / measure source
↓
BACKUP + RECOVERY PROOF
↓
REHEARSAL ON ISOLATED TARGET
↓
MIGRATION PLAN
↓
HUMAN APPROVAL OF EXACT PLAN
↓
COPY
↓
VERIFY IDENTITY + INVARIANTS
↓
SWITCH AUTHORITY
↓
VERIFY RUNTIME
↓
KEEP FALLBACK
Otra migración tendrá adaptadores diferentes. Una base legacy hacia PostgreSQL puede requerir traducción semántica, reconciliación de identidades o una Anti-Corruption Layer en lugar de una copia PostgreSQL a PostgreSQL. También tendrá otros invariantes y otra estrategia de recovery.
Lo portable no son las letras A–P ni una herramienta concreta. Es la separación de responsabilidades: medir antes de tocar, ensayar la receta, aprobar la operación exacta, distinguir copia de autoridad y conservar una salida comprobada.
El destino final puede compartir almacenamiento. No debe compartir autoridad por accidente.